Corey Rosamond · 2026/10/2 · 约 6 分钟阅读
本文为英文原文的简体中文译文。资料和事件日期保留原文发表时的语境;代码示例保持原样。 Read in English
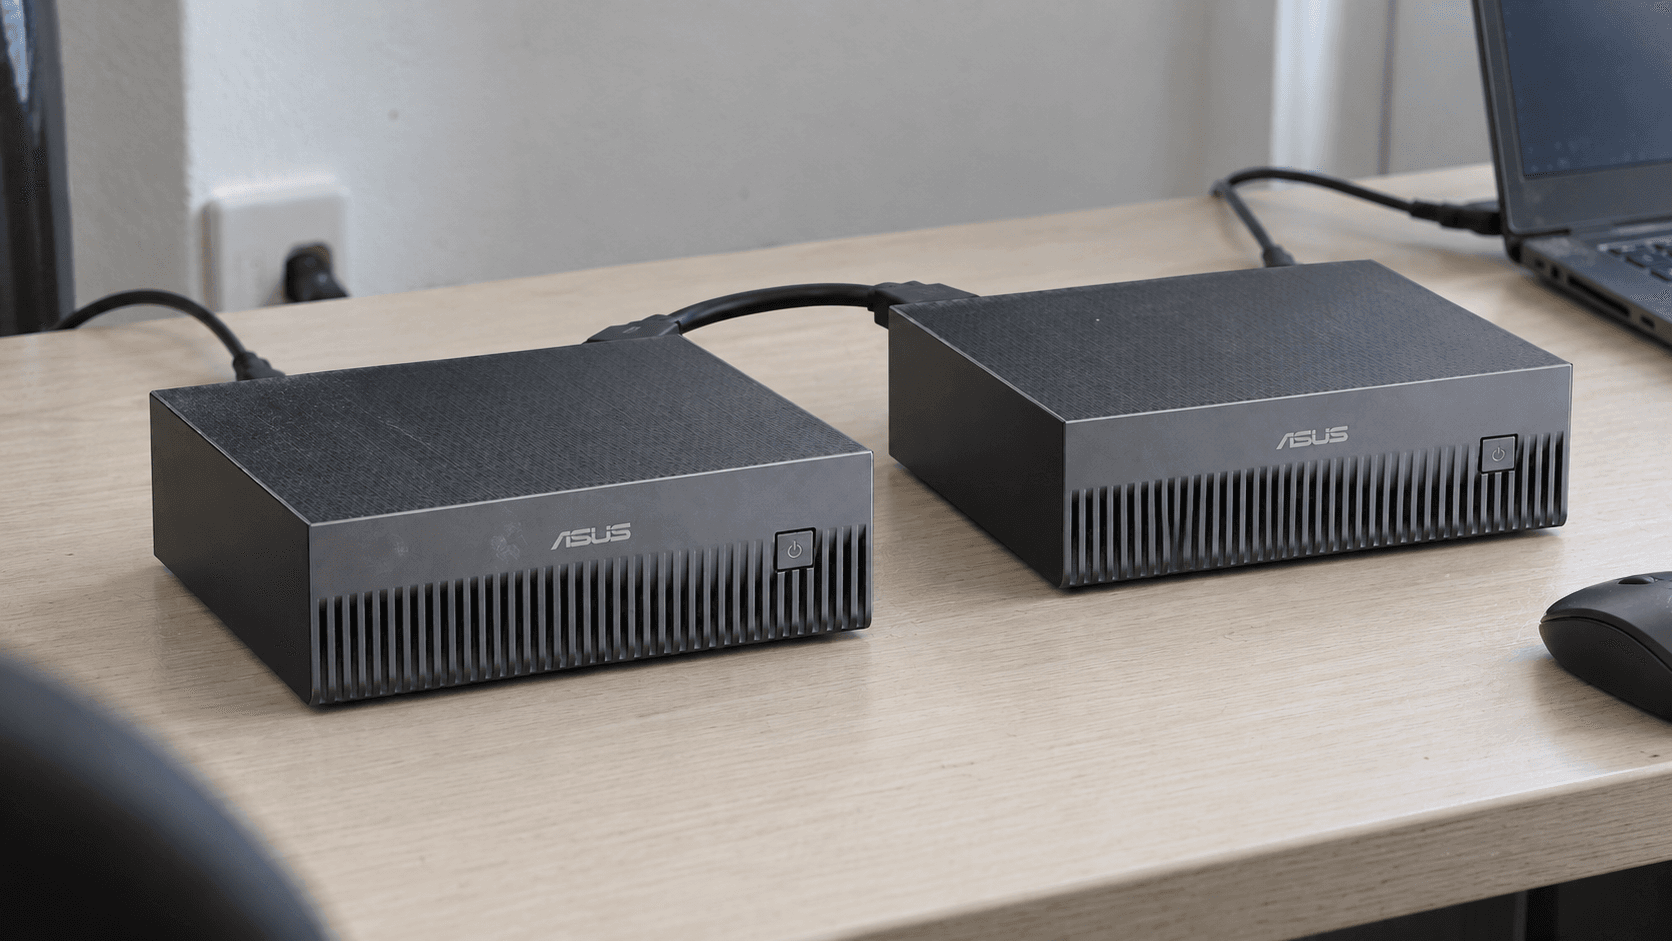
最近让我觉得有意思的一种 AI 升级,是用一条线缆连接两台小电脑。选对硬件并配置好软件后,原本任何一台都装不下的模型,就可能由两台共同运行。
这正是华硕 Ascent GX10 多机方案值得研究的地方。两台可以说明基本思路;八台则进入了另一个级别:约 1 TB 的总装机内存、专用网络,以及一套需要维护的小型集群。
对创业者和工程团队来说,关键是这套设备能让实际工作发生什么变化。公开测试展示了它的潜力,也说明内存容量、响应速度和有用的产出必须分别衡量。
双机测试究竟证明了什么
GX10 采用 NVIDIA GB10 平台,配备 CPU 与 GPU 共享的 128 GB 一致性统一内存,并提供用于连接多机的 ConnectX-7 网络接口。两台合计有 256 GB 装机内存,但不会自动变成一台配有单张 256 GB 显卡的普通电脑。详见华硕规格表。
Techno Tim 在 2026 年 5 月的测试中,先用一台 GX10,再用两台运行编程工作流。双机让他能够运行四位量化的 MiniMax M2.7。调整推理服务配置后,他报告约 41 token/秒;任务运行期间,双机的部分功耗读数约为 280–330 瓦。
这些是他的观察,不是 Rosecraft 的实测数据,也不是性能保证。他在单机与双机测试之间还更换了模型,因此第二次生成的应用更好,不能仅归因于多了一台机器。如果要据此采购,这一点不能省略。
八台机器就是一套小型集群
ServeTheHome 于 4 月 27 日发表的搭建记录连接了八台 GB10 设备,并在本地运行 Kimi K2.5 和 K2.6。这是 GB10 平台的案例,不能据此声称他们测试了八台相同的华硕 GX10。GX10 是华硕的产品名;GB10 是多家厂商采用的 NVIDIA 平台。
数字确实很吸引人:每台 128 GB,八台合计 1,024 GB 装机内存。但操作系统、推理服务和模型运行状态也需要内存。具体模型能用上多少,取决于配置。
该方案使用 400 GbE 交换机和分支线缆连接节点。交换机端口标称 400 GbE,并不意味着每台电脑的链路都达到 400 Gb/s。拓扑、线缆和设备端口的限制仍然存在。
还要区分不同层面的支持范围。NVIDIA 当前的 Sync Cluster Assistant 文档描述了最多三台 Spark 直连,或四台通过交换机连接;其手动交换机配置指南则说明可以扩展到更多设备。有人成功搭出八节点集群,不等于每个模型、推理软件或配置向导都支持八节点。
连接线带来容量,也带来通信开销
软件必须拆分任务。在 NVIDIA 的双 Spark 张量并行示例中,每台保存模型各层的一部分,并与另一台交换中间结果。连接线参与计算过程,并非只在启动时用来传输模型文件。
这种通信有代价。ServeTheHome 的性能分析建议将其 Qwen3.5-397B 配置放在四个节点上,而不是分散到八个节点。GPT-OSS-120B 从单节点扩展到双节点时,吞吐量也远没有翻倍。这些结论对应当时的软件和设置,不是永久有效的配置排名。
在决定节点数量之前,先明确要解决哪种限制:
- 模型装不下。将模型分散到多台机器上,可能让它终于能够运行。还要为上下文和并发请求预留空间。
- 用户排队太久。可以比较多个独立的小模型实例,与一个跨越整个集群的大模型实例。
- 单次回答太慢。测量该请求首次响应及最终完成所需的时间。许多用户合计的高 token 吞吐量,不代表单个用户获得了更快体验。
这是不同的实验。没有先明确瓶颈就购买更多节点,会让结果更难判断。
功耗数字没有涵盖的成本
ServeTheHome 报告,运行 Kimi K2.5 等模型时,包含两台交换机的系统功耗约为 900–950 瓦;相同设备组合的空闲功耗约为 430 瓦。增加 CPU 负载后,功耗可能达到约 1.2 千瓦。这些数字只覆盖该测试配置,并非所有八节点方案,也不包括整个办公室。
举一个电费计算示例:按 925 瓦、每天运行八小时、每月 22 个工作日计算,耗电量为 162.8 千瓦时。假设每千瓦时电费为 0.25 美元,这些工作时段的电费就是 40.70 美元。夜间空闲耗电、其他设备和制冷还需要另算。在断言本地推理更便宜之前,应使用实际电价和实测运行时间。
同一篇四月报告给出的集群价格范围为 23,000–35,000 美元。这是历史参考,不是当前报价。应重新获取机器、交换机、线缆和存储的价格,并计入维护时间。API 账单很显眼,修复故障推理环境所花的工时也属于成本。
先确定工作,再确定预算
对小团队,我会这样安排试点:选一个反复出现的任务,准备有代表性的输入,并约定什么才算可用结果。例如,从企业有权处理的文档中提取指定字段。测试集里应包括模糊扫描件和不完整记录,而不是只有适合演示的整洁样本。
让候选本地方案和现有替代方案完成同一任务。记录模型版本、量化方式、推理服务版本、上下文长度和并发数。先统计正确结果与人工修正,再衡量等待时间、能耗和运维投入。一个很快生成、却需要人工核对十分钟的答案,可能并不划算。
本地运行能让团队更好地控制模型在哪里推理,但不能单凭这一点认定所有文档都留在本地。智能体仍可能调用外部工具,日志和备份也可能传出网络。如果数据本地化是采购理由,就要检查完整工作流。
当有用的模型确实需要更多内存、团队需要控制推理环境,并且有人负责运维时,小型集群有明确价值。八台设备也可以是值得投入的研究平台。如果能够说清它要完成什么工作,并展示哪些地方改善了,采购就更容易得到支持。
Rosecraft 的 AI 评估与集成服务会从实际任务入手。告诉我们你想在本地运行什么、谁来使用,以及哪里需要改善。这些答案比一张设备采购清单更有帮助。
图片为硬件布置示意。引用的公开测试结果归属于原作者。资料核查日期:2026 年 10 月 2 日。